文字数がツールごとに違う理由:バイト、コードポイント、見た目の1文字
同じ文章なのに Word、フォーム、X(旧Twitter)、JavaScript の .length で文字数が変わる理由を、UTF-8 のバイト数、UTF-16、コードポイント、書記素クラスタの違いから整理しました。
X(旧Twitter)には280文字まで書けるはずなのに、日本語だと140文字前後で止まります。X は英数字を1、漢字やかなを2として数える「重み付き」の文字数を使っているからです。同じ文章を応募フォームに貼ると別の数字が出て、開発者ツールで .length を見るとまた違う数字になります。
どれかが間違っているわけではありません。「1文字」を何とみなすかが違うだけで、数え方は大きく分けて4つあります。
同じ文字列、4つの数字
| 入力 | UTF-8 のバイト数 | UTF-16 のコードユニット(JS の .length) |
コードポイント | 見た目の文字数 |
|---|---|---|---|---|
A |
1 | 1 | 1 | 1 |
あ |
3 | 1 | 1 | 1 |
𠮷(「つちよし」) |
4 | 2 | 1 | 1 |
👍 |
4 | 2 | 1 | 1 |
🇯🇵 |
8 | 4 | 2 | 1 |
👨👩👧 |
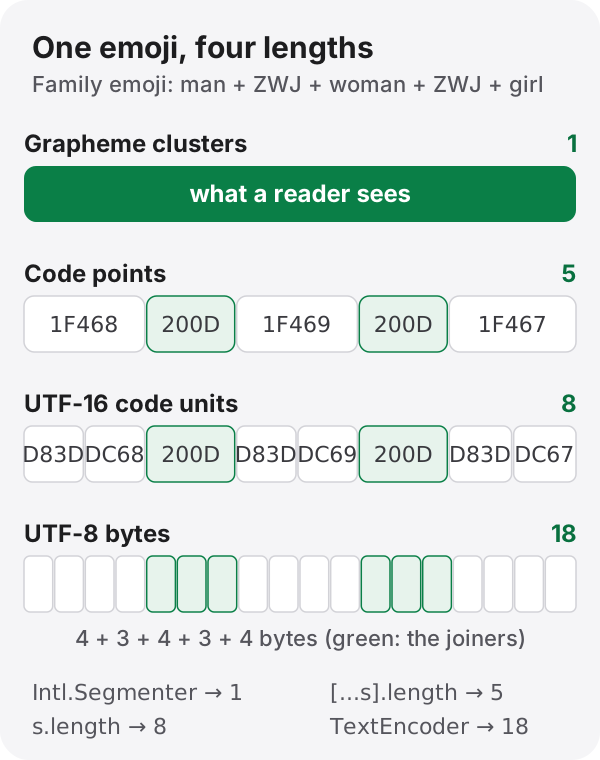
18 | 8 | 5 | 1 |
家族の絵文字は画面上では1文字ですが、Unicode では男性・女性・女の子の3文字を**ゼロ幅接合子(ZWJ、U+200D)**2つでつないだ5文字です。国旗 🇯🇵 も、J と P にあたる「地域指示記号」2文字が並んで1つに見えています。
コードポイントは Unicode の通し番号
Unicode はすべての文字に番号を振っています。あ は U+3042、A は U+0041、👍 は U+1F44D です。この番号の1つ1つがコードポイントです。保存や送信のときはこの番号をバイト列に変えますが、その方式(エンコーディング)によって長さが変わります。
UTF-16 と JavaScript の .length
JavaScript の文字列は UTF-16 で、.length は文字数ではなく 16ビット単位(コードユニット)の数を返します。U+FFFF までの文字は1単位に収まりますが、それより大きい番号はサロゲートペアという2単位に分かれます。
日本語でこれが表に出るのが「𠮷野家」の「𠮷」です。この字は U+20BB7 なので "𠮷".length は2になり、str.slice(0, 1) で切るとペアの片方だけが残って文字化け(�)します。人名や地名の異体字、絵文字を扱うなら避けて通れません。Java の String.length() や C# の string.Length も同じ数え方です。
コードポイント単位で数えるなら、[...str].length のように文字列を展開します。それでも家族の絵文字は5です。
UTF-8 のバイト数:保存と通信の単位
Web や多くのファイルは UTF-8 を使います。ASCII は1バイト、é のようなラテン文字は2バイト、ひらがな・カタカナ・漢字は3バイト、絵文字は4バイトです。「半角は1バイト、全角は2バイト」という感覚は Shift_JIS の頃のもので、UTF-8 では全角文字はほぼ3バイトになります。
バイト数が効いてくるのは主に保存先です。MySQL の VARCHAR(100) は文字セットが utf8mb4 なら100文字(コードポイント)ですが、行全体やインデックスには別にバイト数の上限があります。以前よく使われていた utf8(utf8mb3)は1文字3バイトまでしか保存できないため、4バイトの絵文字や「𠮷」を入れると Incorrect string value エラーになります。Oracle の VARCHAR2(100) は設定によって100バイトを意味するので、日本語なら34文字で超えてしまいます。
見た目の1文字:書記素クラスタ
人が「1文字」と感じる単位を、Unicode は拡張書記素クラスタと呼び、その区切りを UAX #29 で定めています。家族の絵文字、国旗、肌の色付きの 👍🏽(コードポイント2つ)、半角カナの「ガ」(カ と半角濁点の2つ)は、どれも1クラスタです。
ブラウザや Node.js では Intl.Segmenter で数えられます。
const seg = new Intl.Segmenter("ja", { granularity: "grapheme" });
[...seg.segment("👨👩👧")].length; // 1
"👨👩👧".length; // 8利用者に見せる文字数の上限には、この数字がいちばん自然です。絵文字1つを8文字と数える人はいません。
Mac から来たファイル名の濁点
日本語にはもう1つ落とし穴があります。「が」は1文字(U+304C)でも書けますし、「か」(U+304B)の後ろに結合用の濁点(U+3099)を付けた2文字でも書けます。前者を NFC、後者を NFD と呼びます。見た目は同じで書記素も1つですが、.length は1と2になります。
macOS で作ったファイル名は NFD で渡ってくることが多く、Mac で圧縮した ZIP を Windows で展開すると「か゛」のように濁点が分かれて見えたり、アップロードしたファイル名で検索しても見つからなかったりするのはこのためです。比較や保存の前に str.normalize("NFC") でそろえておけば、ほとんどの場合は解決します。
どの数字を基準にするか
目的に合わせて選びます。
- 利用者に見せる上限は書記素クラスタで数えます。
- データベースや API の上限は、その保存先が数える単位(MySQL の
utf8mb4ならコードポイント、バイト上限があるなら UTF-8 のバイト数)で、サーバー側でも確認します。 - 画面側とサーバー側で単位がずれると、「フォームでは通ったのに保存で切れる」不具合になります。両方を同じ単位にそろえることがいちばん大事です。
提出前に文字数をすぐ確かめたいときは、文字数カウントに貼り付けてみてください。スペース込み・スペースなしの文字数、UTF-8 のバイト数、行数、原稿用紙(400字詰め)換算をまとめて表示し、👨👩👧 のように1文字に見えるものは1文字として数えます。文章はブラウザの中だけで数え、サーバーには送りません。
参考
- Unicode Standard Annex #29, Unicode Text Segmentation
- Unicode Standard Annex #15, Unicode Normalization Forms
- RFC 3629, UTF-8, a transformation format of ISO 10646
- ECMAScript 仕様(ECMA-262), The String Type
- MySQL 8.0 Reference Manual, “The utf8mb4 Character Set”, “String Type Storage Requirements”