글자 수가 도구마다 다른 이유: 바이트, 코드 포인트, 눈에 보이는 글자
같은 글인데 워드, 채용 사이트, 문자 메시지, JavaScript가 서로 다른 글자 수를 내놓는 이유를 UTF-8 바이트, UTF-16, 코드 포인트, 눈에 보이는 글자(그래핌 클러스터) 단위로 풀고, 개발할 때 무엇을 기준으로 셀지 정리했습니다.
문자 발송 서비스들은 단문 메시지를 “90바이트, 한글 45자”로 안내합니다. 영어로는 90자까지 쓸 수 있는데 한글은 절반뿐입니다. 문자 메시지는 한글 한 글자를 2바이트, 영문·숫자를 1바이트로 세기 때문입니다. 같은 문장을 웹 폼에 붙이면 또 다른 숫자가 나오고, 개발자 콘솔에서 .length를 찍으면 또 다릅니다.
어느 쪽이 틀린 것은 아닙니다. “글자 하나”를 무엇으로 보느냐가 다를 뿐이고, 세는 단위는 크게 네 가지입니다.
같은 글, 네 개의 숫자
| 입력 | UTF-8 바이트 | UTF-16 코드 유닛 (JS .length) |
코드 포인트 | 눈에 보이는 글자 |
|---|---|---|---|---|
A |
1 | 1 | 1 | 1 |
가 |
3 | 1 | 1 | 1 |
é |
2 | 1 | 1 | 1 |
👍 |
4 | 2 | 1 | 1 |
🇰🇷 |
8 | 4 | 2 | 1 |
👨👩👧 |
18 | 8 | 5 | 1 |
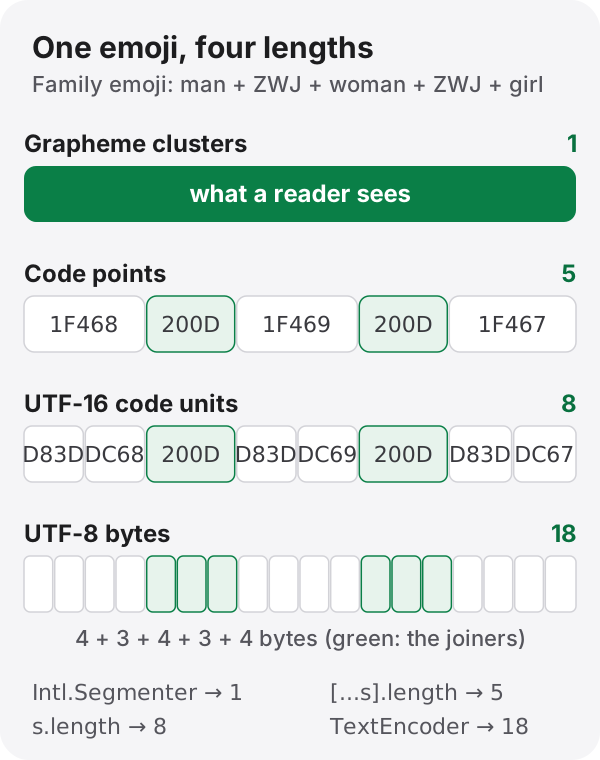
마지막 줄의 가족 이모지는 화면에서 한 글자지만, 유니코드로는 남자·여자·여자아이 세 문자를 제로 폭 결합자(ZWJ, U+200D) 두 개로 이어 붙인 다섯 문자입니다. 국기 🇰🇷도 지역 표시 문자 두 개(K, R에 해당)가 모여 하나로 보이는 것입니다.
코드 포인트: 유니코드가 붙인 번호
유니코드는 모든 문자에 번호를 붙입니다. 가는 U+AC00, A는 U+0041, 👍는 U+1F44D입니다. 이 번호 하나하나가 코드 포인트입니다. 저장하거나 전송할 때는 이 번호를 바이트로 바꾸는데, 그 방식(인코딩)에 따라 길이가 달라집니다.
UTF-16과 JavaScript의 .length
JavaScript의 문자열은 UTF-16으로 되어 있고, .length는 코드 포인트가 아니라 16비트 단위(코드 유닛)의 개수를 셉니다. U+FFFF까지의 문자는 한 단위로 충분하지만, 이모지처럼 그보다 큰 번호는 서로게이트 쌍이라는 두 단위로 나뉩니다. 그래서 "👍".length는 2입니다.
한글 완성형(U+AC00~U+D7A3)은 모두 한 단위에 들어가므로 한국어만 쓰는 동안에는 문제가 드러나지 않습니다. 사용자 이름에 이모지가 들어오는 순간 str.slice(0, 10) 같은 코드가 서로게이트 쌍 한가운데를 잘라, 화면에 깨진 문자(�)가 남습니다. Java의 String.length(), C#의 string.Length도 같은 방식으로 셉니다.
코드 포인트 단위로 세려면 [...str].length처럼 문자열을 펼치면 됩니다. 이렇게 해도 가족 이모지는 5입니다.
UTF-8 바이트: 저장과 전송의 단위
웹과 대부분의 파일은 UTF-8을 씁니다. ASCII는 1바이트, é 같은 라틴 문자는 2바이트, 한글과 한자·가나는 3바이트, 이모지는 4바이트입니다. “자기소개서” 다섯 글자는 UTF-8로 15바이트입니다. 앞에서 말한 문자 메시지의 “한글 2바이트”는 UTF-8이 아니라 문자 메시지 쪽의 셈법이라 숫자가 또 다릅니다.
바이트 수가 중요한 곳은 주로 저장소입니다. MySQL에서 VARCHAR(100)은 문자셋이 utf8mb4라면 100자(코드 포인트)를 뜻하지만, 행 전체와 인덱스에는 바이트 한도가 따로 있습니다. 예전에 흔히 쓰던 utf8(utf8mb3)은 한 글자를 최대 3바이트까지만 저장해서, 4바이트인 이모지를 넣으면 Incorrect string value 오류가 납니다. Oracle의 VARCHAR2(100)은 설정에 따라 100바이트를 뜻하기도 하므로, 한글 34자면 넘칩니다. 컬럼의 길이가 글자인지 바이트인지 먼저 확인해야 하는 이유입니다.
눈에 보이는 한 글자: 그래핌 클러스터
사람이 “한 글자”라고 느끼는 단위를 유니코드는 확장 그래핌 클러스터라고 부르고, 그 경계를 UAX #29에서 정합니다. 가족 이모지, 국기, 피부색이 붙은 👍🏽(코드 포인트 2개), 악센트가 따로 붙은 é(e + U+0301)가 모두 한 클러스터입니다.
브라우저와 Node.js에서는 Intl.Segmenter로 셀 수 있습니다.
const seg = new Intl.Segmenter("ko", { granularity: "grapheme" });
[...seg.segment("👨👩👧")].length; // 1
"👨👩👧".length; // 8글자 수 제한을 사용자에게 보여 준다면 이 숫자가 가장 자연스럽습니다. 사용자는 이모지 하나를 8자로 세지 않으니까요.
맥에서 온 파일 이름의 한글
한글에는 함정이 하나 더 있습니다. 같은 “한글”도 완성형 두 글자(U+D55C U+AE00)로 쓸 수 있고, 자모 여섯 개(ㅎ ㅏ ㄴ ㄱ ㅡ ㄹ에 해당하는 U+1112 U+1161 U+11AB …)로도 쓸 수 있습니다. 앞쪽을 NFC, 뒤쪽을 NFD라고 합니다. 화면에서는 똑같이 보이고 그래핌도 2개지만, .length는 2와 6, UTF-8은 6바이트와 18바이트입니다.
macOS에서 만든 파일 이름은 NFD로 넘어오는 경우가 많습니다. 맥에서 압축한 파일을 윈도우에서 풀었더니 이름이 “ㅎㅏㄴㄱㅡㄹ”처럼 풀어져 보이거나, 업로드한 파일 이름으로 검색이 안 되는 일이 이 때문입니다. 비교하거나 저장하기 전에 str.normalize("NFC")로 맞춰 두면 대부분 해결됩니다.
어느 숫자를 믿을까
기준은 쓰임에 따라 고르면 됩니다.
- 사용자에게 보여 주는 글자 수 제한은 그래핌 클러스터로 셉니다.
- 데이터베이스와 API 한도는 그 저장소가 세는 단위(MySQL
utf8mb4는 코드 포인트, 바이트 한도가 있으면 UTF-8 바이트)로 서버에서 한 번 더 확인합니다. - 화면 쪽 제한과 서버 쪽 제한이 다른 단위를 쓰면, “화면에서는 통과했는데 저장할 때 잘리는” 버그가 생깁니다. 둘을 같은 단위로 맞추는 것이 제일 중요합니다.
제출할 글이 몇 자인지 빨리 확인하고 싶다면 글자수 세기 도구에 붙여 넣어 보세요. 공백 포함·제외 글자 수와 UTF-8 바이트, 줄 수를 함께 보여 주고, 👨👩👧처럼 한 글자로 보이는 것은 1자로 셉니다. 글은 브라우저 안에서만 세고 서버로 보내지 않습니다.
참고
- Unicode Standard Annex #29, Unicode Text Segmentation
- Unicode Standard Annex #15, Unicode Normalization Forms
- RFC 3629, UTF-8, a transformation format of ISO 10646
- ECMAScript 명세(ECMA-262), The String Type
- MySQL 8.0 Reference Manual, “The utf8mb4 Character Set”, “String Type Storage Requirements”