JSON.parse のエラー位置は間違いの場所ではない:よくある JSON エラーまとめ
末尾のカンマ、シングルクォート、コメント、NaN のようにパーサーが拒否するものと、大きな整数や重複キーのようにエラーなしで値が変わるものを RFC 8259 をもとに整理し、エラー位置の読み方を説明します。
設定ファイルを少し書き換えてサーバーを再起動したら、こんなメッセージが出ました。
SyntaxError: Expected double-quoted property name in JSON at position 46 (line 4 column 1)4行目を見ても、閉じ波かっこ } が1つあるだけです。そこには直すものがありません。本当の間違いは1行上、最後の項目の後ろに残したカンマです。
エラー位置は「パーサーがあきらめた場所」
JSON パーサーは先頭から1文字ずつ読み、文法上ありえない文字に出会った時点で止まります。カンマ自体は問題ありません。カンマの次には新しい項目が来るはずなのに } が来たので、パーサーは } の位置を報告します。
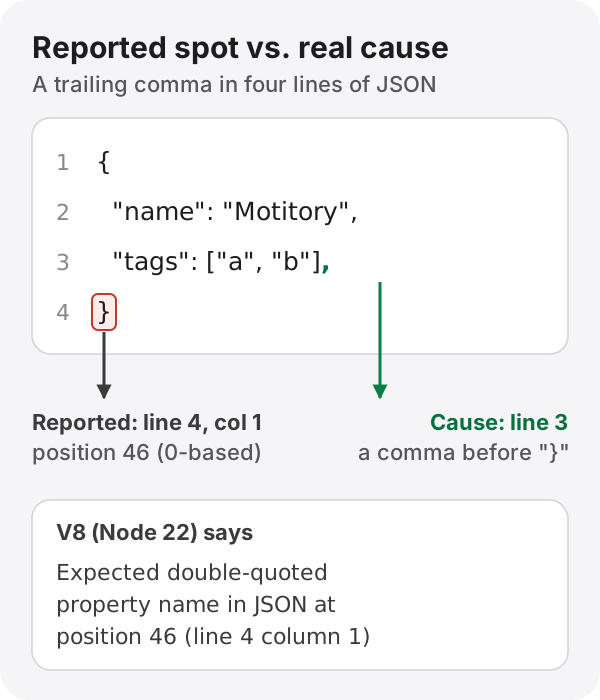
ですから、エラー位置を受け取ったらその場所と直前をあわせて見ます。position の数字は0から数えた文字位置です(正確には UTF-16 のコード単位なので、絵文字1つは2と数えます)。最近の Node や Chrome は (line 4 column 1) のように行と列まで教えてくれますが、バージョンによっては Unexpected token } in JSON at position 46 のように位置だけだったり、前後の文字列を引用するだけだったりします。文言はエンジンごとに違うので、文言より位置を見るほうが早いです。
JavaScript では通るのに JSON では通らないもの
エラーの多くは、JSON を JavaScript のオブジェクトのつもりで書いたときに起きます。見た目は似ていますが、JSON の文法(RFC 8259、ECMA-404)はずっと狭いのです。
| 書いたもの | JavaScript のオブジェクト | JSON |
|---|---|---|
末尾のカンマ [1, 2,] |
可 | エラー |
シングルクォート {'a': 1} |
可 | エラー。文字列とキーはダブルクォートのみ |
クォートなしのキー {a: 1} |
可 | エラー |
コメント // …、/* … */ |
可 | エラー。文法にコメントがない |
NaN、Infinity、undefined |
値として使える | エラー。JSON にない値 |
012、0x1F、.5、+1 |
一部は可 | エラー。先頭の0、16進数、小数点始まり、+ 符号はすべて不可 |
| 文字列の中の生のタブ・改行 | テンプレートリテラルなら可 | エラー。\t、\n と書く |
最後の行は、Excel のセルをコピーして JSON の文字列に貼り付けたときによく起きます。空白に見えても実はタブ文字で、V8 は Bad control character in string literal と教えてくれます。
ファイル先頭の BOM(EF BB BF)もよくある原因です。Windows のメモ帳や一部のエディターが UTF-8 のファイルに付けるもので、画面には見えません。RFC 8259 は JSON の先頭に BOM を付けてはならないとし、パーサーが無視してもよいとしています。実際の動作は分かれます。JSON.parse は1文字目でエラーになり、Python の json.loads は「utf-8-sig でデコードせよ」と親切なメッセージを返します。
エラーなしで値が変わるもの
もっと厄介なのは、パーサーが何も言わずに受け入れるのに、結果が変わってしまう場合です。
大きな整数。 JSON の文法そのものには、数値の大きさの上限がありません。しかし JSON.parse は数値を JavaScript の Number、つまり倍精度浮動小数点数として読むので、2⁵³ を超える整数は最も近い値に丸められます。
JSON.parse('{"id": 9007199254740993}').id; // 9007199254740992注文番号やユーザー ID の末尾が1つずれて届くのに、エラーは出ません。64ビットの ID を文字列で返す API が多いのはこのためです。しくみは浮動小数点の記事に詳しく書きました。同じ JSON を Python で読むと、整数はそのまま残ります。Python の int には大きさの上限がないからです。同じデータが、言語によって別の値になるわけです。
重複キー。 {"a": 1, "a": 2} はエラーではありません。RFC 8259 はオブジェクトの名前が「一意であるべき(SHOULD)」と言うだけで、重複したときの動作は実装によって予測できないと警告しています。JavaScript と Python はどちらも最後の値 2 を残しますが、最初の値を使うパーサーやエラーにするパーサーもあります。設定ファイルをマージして同じキーが2回入ると、上のほうで直した値が無視される理由を長いこと探すことになります。
NaN を受け入れるパーサー。 Python の json モジュールは、既定で NaN と Infinity を読み書きします。json.dumps(float("nan")) の結果は NaN という、標準の JSON ではない文字列です。これを JavaScript 側で JSON.parse するとエラーになります。送る側が Python なら、allow_nan=False で止めておくのが安全です。
JSON.stringify が捨てるもの。 逆方向もあります。undefined や関数を持つプロパティは結果から消え(配列の中では null になり)、NaN と Infinity はどこにあっても null になります。Date は ISO 形式の文字列になり、BigInt はそもそもエラーになります(Do not know how to serialize a BigInt)。送ったオブジェクトと届いたオブジェクトでプロパティの数が違うなら、まずこの規則を疑ってみる価値があります。
コメントを書きたいなら
tsconfig.json や VS Code の settings.json にはコメントを書けます。これらは拡張子が .json なだけで、実際はコメントと末尾のカンマを許す JSONC(JSON with Comments)という形式で、それぞれのツールが専用のパーサーで読んでいます。そのため同じファイルを JSON.parse で直接読むとエラーになります。人が手で編集する設定ファイルにコメントが必要なら JSONC や JSON5 に対応したパーサーを使い、プログラム同士でやり取りするデータは標準の JSON のままにしておくのが無難です。
位置を探してくれるツール
JSON 整形・検証ツールに JSON を貼り付けると、インデントをそろえて表示し、文法が間違っていれば何行目の何列目かを示します。ブラウザのエンジンが位置を教えてくれない場合も、自分で位置を探します。数値は書いたとおりに残すので大きな整数が丸められず、重複キーがあれば別に警告します。図の4行をそのまま入れると4行目1列が表示され、3行目末尾のカンマを消すとすぐに通ります。
参考
- RFC 8259, The JavaScript Object Notation (JSON) Data Interchange Format
- ECMA-404, The JSON Data Interchange Syntax
- ECMAScript 仕様(ECMA-262)、
JSON.parseとJSON.stringify - Python ドキュメント、
json— JSON エンコーダおよびデコーダ