UUID v4 と v7 のどちらを使うか:128ビットの構造と衝突確率
UUID の 8-4-4-4-12 の中でバージョンとバリアントのビットがどこにあるか、v4 の衝突確率が実際どれくらいか、時刻が先頭に入る v7 がデータベースのインデックスに向く理由を RFC 9562 をもとに整理しました。
会員ページの URL が /users/1043 になっているサービスでは、誰かが必ず末尾を 1044 に書き換えて試します。権限チェックがきちんとしていれば何も表示されませんが、「このサービスの会員はまだ千人ちょっと」という情報は伝わってしまいます。2つのシステムのデータを統合するときも困ります。どちらにも 1043 番がいるからです。
そこで ID を d25c11b5-3995-48e8-8c0f-8be9a1550bcc のような UUID に切り替えることにしたとします。次に決めるのは「どの UUID にするか」です。いまはたいてい v4 と v7 のどちらかを選ぶことになり、その違いは32桁のうち先頭の12桁にあります。
32桁の中で決まっている2文字
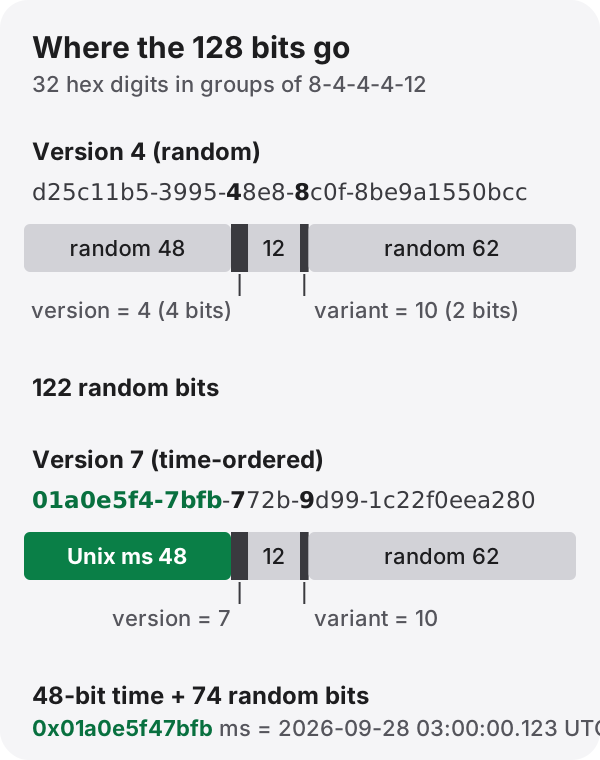
UUID は128ビットの値を16進数32桁で書き、8-4-4-4-12 桁でハイフンを入れたものです。そのうち2か所はランダムではありません。
- 3番目のグループの先頭の文字がバージョンです。
48e8の4が「v4 である」ことを示します。 - 4番目のグループの先頭の文字にはバリアントのビットが入ります。現在使われている UUID ではこの位置の上位2ビットが
10なので、文字としては必ず8・9・a・bのどれかになります。
この2文字を見れば、どの UUID もすぐにバージョンがわかります。ログに出ている ID の3番目のグループが 7 で始まっていれば v7 です。
v4:122ビットのサイコロ
v4 は、バージョンとバリアントに使う6ビットを除いた 122ビットすべてを乱数で埋めます。取りうる値は 2¹²² 通り、約 5.3×10³⁶ 通りです。
「それでもいつか重なるのでは」という疑問には、誕生日問題で答えられます。N 通りの値から k 個をランダムに選んだとき、1組でも重なる確率はおよそ k²/(2N) です。計算すると次のとおりです。
| 生成した UUID の数 | 1度でも重なる確率 |
|---|---|
| 10億個(10⁹) | 約 9.4×10⁻²⁰ |
| 1兆個(10¹²) | 約 9.4×10⁻¹⁴ |
| 約 2.7×10¹⁸ 個 | 約50% |
最後の行に届くには、1秒に10億個ずつ86年間作り続ける必要があります。現実に衝突を心配すべきなのは数学ではなく、乱数が悪いときです。Math.random() のような暗号論的でない乱数で UUID らしきものを作った場合や、仮想マシンを複製して乱数生成器の状態まで同じになった場合です。ブラウザや Node.js の crypto.randomUUID() は暗号論的乱数で v4 を作るので、この心配はほぼなくなります。
ランダムだからこその弱点:インデックス
v4 の弱点は衝突ではなく、値に順序がないことです。PostgreSQL や MySQL(InnoDB)の標準的なインデックスは B-tree で、キーを並べた状態でページに分けて持ちます。自動採番の ID なら新しい値は常に右端に付くので、使われるのは最後のページだけです。
v4 は新しい値がインデックスのどこにでも落ちます。行数が数千万になると、挿入のたびにメモリにないページをディスクから読む可能性が高くなり、満杯のページがあちこちで分割されます。書き込みは遅くなり、インデックスはすかすかになります。テーブルそのものを主キー順に格納する MySQL の InnoDB では、特に影響が大きくなります。
v7:先頭48ビットに時刻を入れる
2024年5月に公開された RFC 9562 は、それまでの RFC 4122 を置き換え、新しいバージョン v6・v7・v8 を定めました。このうち v7 が上の問題への答えです。
v7 の先頭48ビットはミリ秒単位の UNIX 時間です。その後ろにバージョン4ビット、ランダム12ビット、バリアント2ビット、ランダム62ビットが続きます。ランダムな部分は74ビットと v4 より少なくなりますが、同じミリ秒の中で重ならなければよいので十分です。
01a0e5f4-7bfb-772b-9d99-1c22f0eea280 の先頭12桁 01a0e5f47bfb を10進数にすると 1790564400123 で、これは 2026年9月28日 03:00:00.123 UTC、日本時間ではちょうど正午を 0.123 秒過ぎたところです。後から作った UUID ほど値が大きくなるので、文字列として並べ替えてもほぼ作成順になります(同じミリ秒の中の順序は実装しだいです)。インデックスでは自動採番の ID と同じように右端に積み上がります。
48ビットのミリ秒は西暦10889年まで数えられるので、寿命の心配はいりません。その代わり、作成時刻が ID からそのまま読めることは覚えておく必要があります。会員 ID から登録日時がわかっても問題ないかどうかは、サービスごとに判断することです。
v1 と v6 はどうなったか
v1 は、1582年10月15日から数えた100ナノ秒単位の時刻と機器の MAC アドレスから作ります。MAC アドレスが入るのでどの機械で作った ID かがわかり、時刻のビットが入れ替わった順序で並んでいるため、並べ替えても時刻順になりません。v6 は v1 の時刻ビットを順番どおりに並べ直したもので、すでに v1 を使っているシステムのためのバージョンです。新しく始めるなら、RFC 9562 自身も v1・v6 より v7 を使うよう勧めています。
どれを選ぶか
| 自動採番の整数 | UUID v4 | UUID v7 | |
|---|---|---|---|
| サイズ | 4〜8バイト | 16バイト | 16バイト |
| 次の値の推測 | 簡単 | できない | 時刻部分は可能、残りは不可能 |
| 複数の場所で同時に発行 | 中央での採番が必要 | できる | できる |
| B-tree への挿入 | 末尾に追加 | どこにでも | ほぼ末尾に追加 |
| 作成時刻がわかるか | 順序だけ | わからない | ミリ秒まで |
データベースの主キーに UUID を使うなら、v7 が無難です。PostgreSQL 18 には uuidv7() 関数が、Python 3.14 には uuid.uuid7() が標準で入っています。時刻がわかると困る値、たとえば共有リンクのトークンなら v4 のほうがよく、推測されないことそのものが目的なら、UUID より長い乱数トークンを使う手もあります。いずれにしても、UUID にしたから権限チェックを省いてよいということにはなりません。
UUID 生成ツールは、ブラウザの暗号論的乱数で v4 と v7 をまとめて作ります。v7 をいくつか作ってみると、先頭の桁はほとんど同じで、後ろに行くほど変わる様子が見られます。
参考
- RFC 9562, Universally Unique IDentifiers (UUIDs)(2024年)
- RFC 4122, A Universally Unique IDentifier (UUID) URN Namespace(RFC 9562 により廃止)
- W3C Web Cryptography API,
Crypto.randomUUID() - PostgreSQL 18 ドキュメント「UUID Functions」、Python 3.14 ドキュメント
uuidモジュール