JSON.parse 에러가 가리키는 곳이 틀린 곳은 아니다: 자주 나는 JSON 오류 정리
끝에 남은 쉼표, 작은따옴표, 주석, NaN처럼 JSON 파서가 거절하는 것과, 큰 정수·중복 키처럼 오류 없이 값이 바뀌는 것을 RFC 8259 기준으로 정리하고 에러 위치를 읽는 법을 설명합니다.
설정 파일을 조금 고치고 서버를 다시 띄웠더니 이런 메시지가 나왔습니다.
SyntaxError: Expected double-quoted property name in JSON at position 46 (line 4 column 1)4번째 줄로 가 보면 닫는 중괄호 } 하나뿐입니다. 거기에는 고칠 것이 없습니다. 실제로 틀린 곳은 한 줄 위, 마지막 항목 뒤에 남겨 둔 쉼표입니다.
에러 위치는 “파서가 포기한 곳”이다
JSON 파서는 글자를 앞에서부터 하나씩 읽다가, 문법상 올 수 없는 글자를 만나는 순간 멈춥니다. 쉼표 자체는 문제가 없습니다. 쉼표 다음에는 새 항목이 와야 하는데 }가 왔기 때문에, 파서는 }의 위치를 보고합니다.
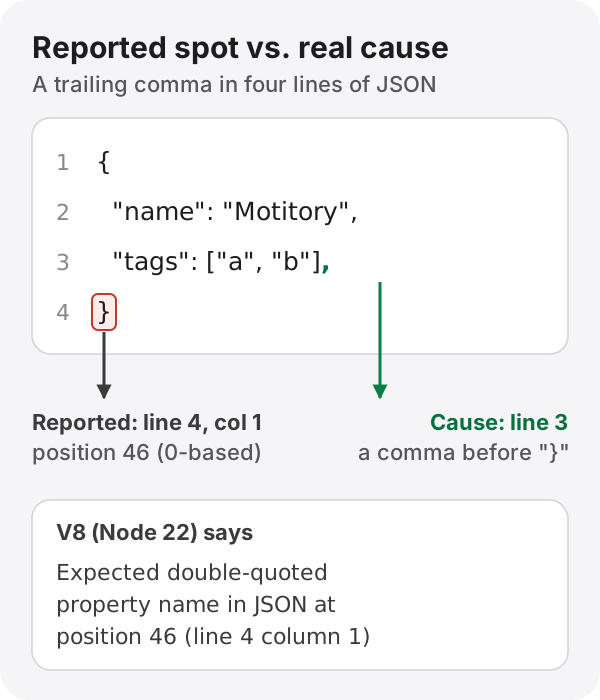
그래서 에러 위치를 받으면 그 자리와 바로 앞을 함께 봐야 합니다. position 숫자는 0부터 세는 글자 위치입니다(정확히는 UTF-16 코드 단위라서 이모지 하나는 2로 셉니다). 최근 Node와 Chrome은 (line 4 column 1)처럼 줄과 열까지 알려 주지만, 버전에 따라 Unexpected token } in JSON at position 46처럼 위치만 주거나 앞뒤 문자열을 인용하기도 합니다. 메시지 문구는 엔진마다 다르니 문구보다 위치를 보는 편이 빠릅니다.
JavaScript에서는 되는데 JSON에서는 안 되는 것
오류의 대부분은 JSON을 JavaScript 객체처럼 쓰다가 생깁니다. 둘은 생김새가 비슷하지만 JSON의 문법(RFC 8259, ECMA-404)이 훨씬 좁습니다.
| 쓴 것 | JavaScript 객체 | JSON |
|---|---|---|
끝에 남은 쉼표 [1, 2,] |
허용 | 오류 |
작은따옴표 {'a': 1} |
허용 | 오류. 문자열과 키는 큰따옴표만 |
따옴표 없는 키 {a: 1} |
허용 | 오류 |
주석 // …, /* … */ |
허용 | 오류. 문법에 주석이 없음 |
NaN, Infinity, undefined |
값으로 씀 | 오류. JSON에 없는 값 |
012, 0x1F, .5, +1 |
일부 허용 | 오류. 앞자리 0, 16진수, 소수점으로 시작, + 부호 모두 불가 |
| 문자열 안의 실제 탭·줄바꿈 | 템플릿 문자열에서는 허용 | 오류. \t, \n으로 써야 함 |
마지막 줄은 스프레드시트에서 셀을 복사해 JSON 문자열 안에 붙여 넣을 때 자주 생깁니다. 눈에는 공백처럼 보여도 탭 문자라서, V8은 Bad control character in string literal이라고 알려 줍니다.
파일 맨 앞의 BOM(EF BB BF)도 흔한 원인입니다. 윈도우 메모장이나 일부 편집기가 UTF-8 파일 앞에 붙이는데, 화면에는 보이지 않습니다. RFC 8259는 JSON 앞에 BOM을 붙이지 말라고 하면서, 파서가 무시해도 된다고 적어 두었습니다. 실제 동작은 갈립니다. JSON.parse는 첫 글자에서 오류를 내고, Python의 json.loads는 “utf-8-sig로 디코딩하라”는 친절한 메시지를 줍니다.
오류 없이 값이 바뀌는 것
더 곤란한 것은 파서가 아무 말 없이 받아들이는데 결과가 달라지는 경우입니다.
큰 정수. JSON 문법 자체는 숫자의 크기에 제한이 없습니다. 하지만 JSON.parse는 숫자를 JavaScript의 Number, 즉 배정밀도 부동소수점으로 읽기 때문에 2⁵³을 넘는 정수는 가장 가까운 값으로 바뀝니다.
JSON.parse('{"id": 9007199254740993}').id; // 9007199254740992주문 번호나 사용자 ID가 끝자리 하나 다르게 들어오는데 오류는 없습니다. 이런 이유로 64비트 ID를 문자열로 주는 API가 많습니다. 원리는 부동소수점 글에 자세히 적었습니다. 같은 JSON을 Python에서 읽으면 정수가 그대로 남습니다. Python의 int는 크기 제한이 없기 때문입니다. 같은 데이터가 언어에 따라 다른 값이 되는 셈입니다.
중복 키. {"a": 1, "a": 2}는 오류가 아닙니다. RFC 8259는 객체의 이름이 “고유해야 한다(SHOULD)“고만 하고, 중복되었을 때의 동작은 구현마다 다르다고 경고합니다. JavaScript와 Python은 둘 다 마지막 값 2를 남기지만, 앞의 값을 쓰는 파서나 오류를 내는 파서도 있습니다. 설정 파일을 합치다 같은 키가 두 번 들어가면, 위쪽에서 고친 값이 무시되는 이유를 한참 찾게 됩니다.
NaN을 받아 주는 파서. Python의 json 모듈은 기본 설정에서 NaN과 Infinity를 읽고 씁니다. json.dumps(float("nan"))의 결과는 NaN이라는, 표준 JSON이 아닌 문자열입니다. 이것을 JavaScript 쪽에서 JSON.parse하면 오류가 납니다. 보내는 쪽이 Python이라면 allow_nan=False로 막아 두는 편이 안전합니다.
JSON.stringify가 버리는 것. 반대 방향도 있습니다. undefined나 함수가 들어 있는 속성은 결과에서 사라지고(배열 안에서는 null로 바뀌고), NaN과 Infinity는 어디에 있든 null이 됩니다. Date는 ISO 형식의 문자열이 되며, BigInt는 아예 오류를 냅니다(Do not know how to serialize a BigInt). 보낸 객체와 받은 객체의 속성 수가 다르다면 이 규칙을 먼저 의심해 볼 만합니다.
주석을 달고 싶다면
tsconfig.json이나 VS Code의 settings.json에는 주석을 달 수 있습니다. 이 파일들은 확장자만 .json일 뿐, 실제로는 주석과 끝의 쉼표를 허용하는 JSONC(JSON with Comments) 형식이고, 각 도구가 전용 파서로 읽습니다. 그래서 같은 파일을 JSON.parse로 직접 읽으면 오류가 납니다. 사람이 손으로 고치는 설정 파일에 주석이 필요하다면 JSONC나 JSON5를 지원하는 파서를 쓰고, 프로그램끼리 주고받는 데이터는 표준 JSON으로 남겨 두는 것이 무난합니다.
위치를 찾아 주는 도구
JSON 정렬·검사기에 JSON을 붙여 넣으면 들여쓰기를 맞춰 보여 주고, 문법이 틀렸으면 몇 번째 줄 몇 번째 칸인지 짚어 줍니다. 브라우저 엔진이 위치를 알려 주지 않을 때도 자체적으로 위치를 찾습니다. 숫자는 쓴 그대로 남기므로 큰 정수가 바뀌지 않고, 중복 키가 있으면 따로 경고합니다. 위 그림의 네 줄을 그대로 넣어 보면 4행 1열이 표시되고, 3행 끝의 쉼표를 지우면 바로 통과합니다.
참고
- RFC 8259, The JavaScript Object Notation (JSON) Data Interchange Format
- ECMA-404, The JSON Data Interchange Syntax
- ECMAScript 명세(ECMA-262),
JSON.parse와JSON.stringify - Python 문서,
json— JSON encoder and decoder