REAを安全に始める:最初の練習、チーム向けチェックリスト、30/60/90日の計画
最初に知っておくこと、公式の Notes フィクスチャで行うリスクの低い最初の調査、チーム向けのチェックリスト、提案する成功基準、中止条件を含む30/60/90日の試験導入計画をまとめました。
シリーズの前の3本では、他の人が何を試したか、ドキュメントが何を可能としているか、設計が何と引き換えになっているかを見てきました。最後の1本は実践の話です。大事なものを危険にさらさずに REA を試すにはどうすればよいか。そしてチームは、使い続ける価値があるかをどう判断すればよいか。
概要記事には、一般的な学習の順序と「自分で書いたプログラムで練習する」方法がすでに載っています。この記事は範囲を絞り、公式のフィクスチャを使う練習ひとつと、試験導入の計画を扱います。
- 最近の記事は実際に何を試したのか
- できることと限界
- 長所と引き換えになるもの、これからのシナリオ
- 安全に始めるために(この記事)
確認日は 2026年10月14日です。 ここで触れるコマンドやオプションは、同日に確認した 6.4.0 の公式ドキュメントの説明であり、いつでも通用する手順ではありません。インストールするバージョンの公式の始め方のページに必ず従ってください。Motitory は REA を実行していないので、以下の手順は私たちの実行結果の報告ではありません。チェックリスト、成功基準、30/60/90日の計画は Motitory の提案であり、REA の要件でも業界標準でもありません。
何よりも先に:許可とデータ
以下のすべての手順に、2つの原則がかかわります。
- 自分が所有している、または明示的に許可を得たものだけを解析してください。 REA の MIT ライセンスは REA のコードについてのものです。解析対象への権利は与えず、Ghidra、JADX、Frida などの外部ツールにはそれぞれのライセンスがあります(外部ツール)。ダウンロードできることは許可ではありません。この記事は法的助言ではなく、確信が持てないなら解析しないでください。
- 「ローカル」でも結果はモデルに届きます。 REA はあなたのマシンでツールを動かしますが、エージェントを接続していれば、ツールの出力はそのモデル提供者に送られます。また、ブラウザ、プロキシ、端末、Frida といったランタイムの経路は状態を変えることがあります(ローカルへの影響)。最初の練習がランタイムの経路と機微な対象の両方を避けるのは、そのためです。
最初に知っておくこと
学習の全体像は概要記事にあります。この練習と試験導入に必要な最低限は次のとおりです。
| レベル | 知っておくこと | ここで大事な理由 |
|---|---|---|
| 入門 | 何を解析してよく、何が範囲外か | ほかのすべてがこれに左右される |
| 入門 | シェルの操作:絶対パス、JSON 出力の読み方 | 設定も Evidence も JSON |
| 入門 | JavaScript の基礎:モジュール、import、イベントハンドラ | 最初の対象が Electron アプリ |
| 入門 | 観察・推論・不明を区別すること | Evidence を読むための中心的な技能 |
| 中級 | C、ポインタとメモリ、呼び出し規約、実行ファイル形式 | ネイティブの対象を扱う前に |
| 中級 | 逆コンパイラが間違えるところ | 疑似コードはソースではない |
| 中級 | 仮想マシン、別アカウント、ネットワークの規則による隔離 | ランタイムの経路を使う前に |
| 中級 | CDP やネットワークキャプチャに見えるもの | ブラウザ・プロキシの経路は機微なデータを記録する |
| 中級 | ローカル MCP サーバーの脅威モデル | REA はサンドボックスではない(セキュリティの境界) |
| 中級 | サプライチェーンと外部ツールのライセンス | provider は自分でインストールし、ライセンスを揃える |
考えうるかぎりリスクの低い最初の練習
対象は、プロジェクトが用意している Notes の例です。最初の調査ガイドと notes-example.zip がそれで、小さく、公開されていて、解析するために作られています。自分で書いたプログラムを使ってもかまいません。この練習では、それ以外のものは使わないでください。
1. バージョンを選んで固定する。 レビュー済みのリリースをひとつ選び(この記事の時点なら 6.4.0)、そのリリースノートを読みます。main と npm のリリースは違うことを覚えておき(リリースと main)、ひとつの練習の中で両者を混ぜないでください。
2. どこまで慎重に進めるかを決める。
- いちばん慎重な方法: エージェントを接続せず、CLI で静的解析だけを行います。自分で貼り付けないかぎり、モデル提供者には何も届きません。
- エージェントと一緒に: 6.4.0 のドキュメントは、まず
setupを--client <クライアント> --dry-run --jsonで実行するよう説明しています。何が変わるかを読んで自分で承認し、そのクライアントひとつに範囲を絞って本番の設定を行い、doctor --client <クライアント> --jsonで結果を確かめます。正確なコマンドはここではなく、始め方のページから取ってください。
3. 元のファイルには触れない。 公式サイトから ZIP をダウンロードして SHA-256 のハッシュを記録し、読み取り専用のコピーを保管します。作業は、消してかまわないフォルダのコピーで行います。
4. 狭い質問をひとつ、静的に投げる。 たとえば 「ユーザーが Export notes を選ぶと、データは CSV になるまでにどの関数を通り、フォーマッタはメモの中のカンマ、ダブルクォート、改行をどう扱うのか」 といった質問です。静的解析だけを許可し、REA でアプリを実行しないでください。
5. 答えを3つの欄に分ける。 Evidence が示していること(ファイルと位置つき)、エージェントが推論したこと、不明と書かれていることです。不明が1つもなければ、もう一度見直してください。同じフィクスチャでの独立した実行でも、プロジェクト全体のグラフには44件が残っていました(第1回)。
6. 予測をひとつ、独立に確かめる。 具体的な予測をひとつ選びます。たとえば、タイトルが He said "hi", then left のメモが CSV でどんな行になるはずか、です。それをエージェントの外で自分で確かめます。フィクスチャのソースにあるフォーマッタを自分で読むか、それが普通の関数なら、消してかまわないフォルダで短いテストから呼び出してみます。そして RFC 4180 がクォートとカンマをどう扱うかと比べます。予測が当たれば2種類の根拠を持つ主張がひとつでき、外れればそのぶん多くを学べます。
7. 記録する。 バージョン、ZIP のハッシュ、質問、レビューを含めてかかった時間、確かめた主張を書き残します。この記録があるから、練習を繰り返し、あとで比べることができます。
チーム向けのチェックリスト
チームでさらに進めるなら、最初の本番の対象に取りかかる前に答えておきたい問いです。項目ごとに社内文書1ページで足ります。
- 許可。 対象ごとに所有者の書面による承認と、許可する操作の明確な範囲(静的解析だけか、特定のランタイムの経路までか)。
- 環境。 秘密情報、Cookie、顧客データのない、使い捨てで権限の低い環境。元のファイルはハッシュを残し、読み取り専用で保管。
- サプライチェーン。 公式の入手元からだけインストール。バージョン、ダイジェスト、ロックファイルを固定。dry-run の出力をレビュー。設定はクライアントひとつに限定。更新は別に計画した時間に。
- 接続と統制。 stdio かループバックだけ。呼び出しごとに正確なコマンドを表示。ファイルシステムと外部通信を制限し、エージェントから見えるツールを絞り込み、destructive や端末の変更と表示されたものは呼び出しごとに承認。REA の注釈はヒントにすぎず、承認を強制するのはクライアントであることを忘れない。
- データ。 対象に何が含まれるかを分類。モデル提供者のデータポリシーを確認。可能なところはマスク。Evidence の保存期間、アクセス権、削除方法を決める。
- 進め方。 狭い質問。静的解析から始め、仮説を立て、必要なときだけ承認済みの動的な手順へ。事実・推論・不明を分ける。重要な結論には2種類の根拠。
- 運用。 元に戻す計画。provider のプロジェクトとキャプチャの後片付け。毎月またはリリースごとの、OS・provider・REA のバージョンの互換性確認。インシデントの報告経路。
うまくいっているかの判断:提案する基準
試験導入のために私たちが提案する基準であって、普遍的な標準ではありません。数字は各自で決めてかまいませんが、始める前に決めてください。
| 測るもの | 提案する基準 |
|---|---|
| 直接の根拠がある重要な主張 | 100% |
| 主張の適合率(確かめたときに正しい主張) | 95%以上 |
| 誤った確信(事実として述べたが、実際は不明または誤り) | 全体で2%以下、高リスクの主張は0 |
| 再現性(同じバージョンと入力で同じ重要な結論) | 95%以上 |
| レビュー時間を含めた時間短縮の中央値 | 30%以上 |
| 許可のないアクセス、意図しない外部送信、秘密情報の露出 | 0 |
| 製品・セキュリティに関する結論への人の承認 | 100% |
いちばん大事で、いちばん水増ししやすいのが時間短縮です。実行がどれだけ速く終わったかではなく、誰かが Evidence を読むのに使った時間まで数えてください。
30/60/90日の計画
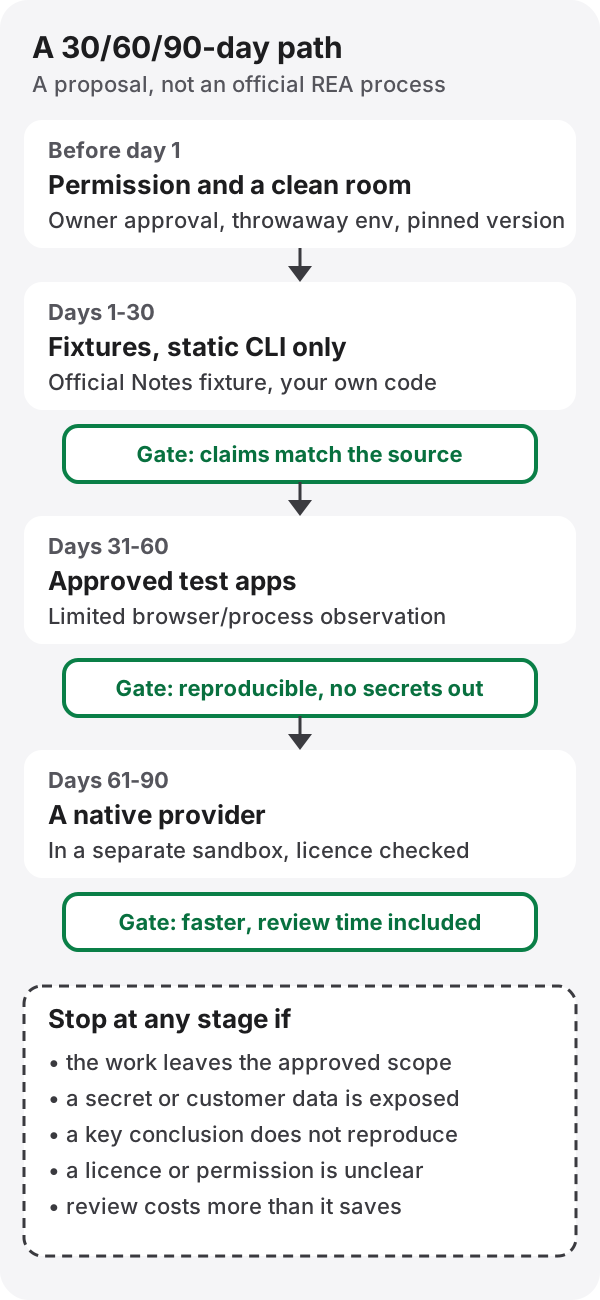
- 1〜30日目:フィクスチャ、静的な CLI。 公式のフィクスチャや自作の社内フィクスチャなど、答えがわかっている対象。目的は感覚をつかむことです。エージェントはどれくらいの頻度で正しく、どれくらいの頻度で「わからない」と認めるのか。
- 31〜60日目:承認されたテストアプリ、限定的な観察。 使い捨ての環境で、自社のテストビルドを対象に、承認された範囲だけブラウザやプロセスを観察します。目的は、実行時の根拠が何を加え、設定とレビューにどれだけのコストがかかるかを見ることです。
- 61〜90日目:別のサンドボックスでネイティブ provider。 ライセンスを確認した Ghidra などの provider を、別のサンドボックスに加えます。目的は、あなたの対象にとってネイティブの経路がその手間に見合うかを見ることです。
どの段階でも止めてください。 作業が承認された範囲を外れた、秘密情報が露出した、重要な結論が再現できない、ライセンスがはっきりしない、レビューのコストが節約した時間を上回った、という場合です。止めることも試験導入の結果のひとつであって、失敗ではありません。
シリーズの終わりに
4本を通じて見えてくる姿は一貫しています。REA のいちばん強い考え方は、何を見なかったかを語る結果です。公開された実績は独立した実行2件で、どちらも JavaScript でした。限界は provider、プラットフォーム、権限、そして静的に読んだことと実行したときの真実との隔たりから来ています。いちばん安全な入口は、小さく、自分のもので、静的で、記録が残る練習です。丁寧に何かを実行して Evidence を公開すれば、このシリーズよりも多くのことを、REA についての私たちみんなの理解に付け加えることになるでしょう。
参考資料
- 公式の入門資料:始め方、最初の調査、Notes の例の ZIP
- コミット
29d3dcbの REA:リリースと main、ローカルへの影響、信頼できない対象コンテンツ、セキュリティの境界、責任ある利用、外部ツール - リリース:rea-agents-6.4.0
- エコシステム:MCP セキュリティのベストプラクティス、OpenAI Agents SDK:MCP の承認と絞り込み
- このブログ:REA の概要、CSV と RFC 4180
リンクと内容は 2026年10月14日に確認しました。