REA(Reverse Engineer Anything) 정리: 에이전트에게 분석 도구를 연결하는 방식, 배울 것, 지켜볼 것
GitHub에서 빠르게 주목받은 REA가 무엇이고 무엇이 아닌지, 에이전트와 함께하는 조사 흐름, 시작 전에 알아 두면 좋은 배경지식과 학습 순서, 안전과 권리의 경계를 공식 문서를 기준으로 정리했습니다.
REA(Reverse Engineer Anything, morluto/rea)는 AI 코딩 에이전트가 리버스 엔지니어링 도구를 쓸 수 있게 이어 주는 오픈 소스 프로젝트입니다. 프로젝트 문서는 REA를 MCP 서버와 CLI로 제공되는 다리이자, 에이전트와 함께 바이너리와 앱을 조사하는 작업 방식으로 설명합니다. 에이전트가 질문을 받으면 REA를 통해 로컬 분석 도구를 부르고, 그 결과를 근거로 답을 만드는 구조입니다.
이 글은 이 블로그의 정기 CS 글과 따로, 최근 주목받는 도구 하나를 소개하는 글입니다. 프로젝트에 관한 설명은 모두 공식 저장소와 rea.tools의 문서를 기준으로 했고, 이 글에서 직접 벤치마크를 하거나 REA를 실행해 본 결과는 없습니다.
REA가 아닌 것부터
이름이 “무엇이든 리버스 엔지니어링”이라서 기대가 커지기 쉽습니다. 문서를 읽고 나면 다음 세 가지는 분명히 해 둘 만합니다.
- 스스로 진실을 알아내는 기계가 아닙니다. REA가 돌려주는 것은 도구의 출력입니다. 그 출력을 해석하고 설명을 만드는 것은 에이전트, 곧 언어 모델이고, 디컴파일러의 결과와 모델의 설명은 모두 불완전하거나 틀릴 수 있습니다.
- 샌드박스가 아닙니다. 프로젝트의 보안 정책은 REA가 격리 환경이 아니라는 점, 그리고 같은 사용자 권한으로 돌아가는 악성 프로세스는 위협 모델 밖이라는 점을 밝힙니다. 의심스러운 파일을 다룬다면 격리는 REA가 아니라 여러분이 따로 마련해야 합니다.
- “로컬 분석”이 “아무도 보지 않는다”는 뜻은 아닙니다. 문서에 따르면 분석은 여러분의 컴퓨터에서 실행되고 REA가 대상 파일을 어딘가로 올리지는 않습니다. 하지만 도구 결과는 에이전트에게 전달되고, 에이전트는 그 내용을 모델 제공자에게 보냅니다. 그 데이터가 어떻게 다뤄지는지는 여러분이 쓰는 에이전트와 모델 제공자의 데이터 정책을 따릅니다.
조사는 어떤 흐름으로 돌아가나
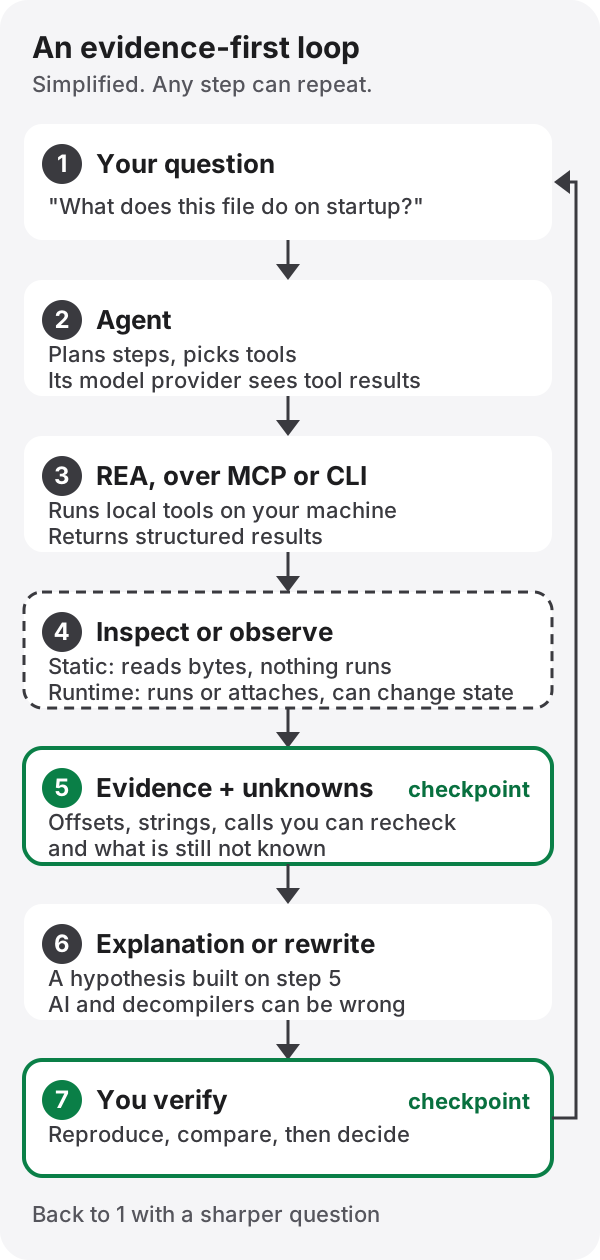
그림은 실제보다 단순하게 그렸습니다. 실제 조사는 단계를 여러 번 오가고, 한 질문에 도구를 여러 번 부르기도 합니다. 그래도 뼈대는 이렇습니다.
- 질문. “이 프로그램은 시작할 때 어떤 파일을 읽나?“처럼 답이 확인 가능한 질문일수록 좋습니다.
- 에이전트. 질문을 단계로 쪼개고 어떤 도구를 부를지 고릅니다.
- REA. MCP 서버로 붙거나 CLI로 호출되어, 로컬에 있는 분석 도구(문서에서는 provider라고 부릅니다)를 실행하고 결과를 정리된 형태로 돌려줍니다. 어떤 MCP 도구가 있고 각각 무엇을 돌려주는지는 MCP 계약 문서에, CLI와 근거 출력은 CLI 문서에, 구성 요소의 관계는 아키텍처 다이어그램 소스에 있습니다.
- 들여다보기 또는 관찰하기. 여기서 성격이 크게 갈립니다. 파일의 바이트를 읽기만 하는 정적 분석은 대상을 실행하지 않습니다. 반면 대상을 실행하거나, 실행 중인 프로세스에 디버거를 붙이거나, 네트워크 트래픽을 캡처하거나, 연결된 기기를 조작하거나, 디버거와 provider의 명령을 제한 없이 넘기는 작업은 대상과 주변 시스템의 상태를 바꿀 수 있습니다. 두 종류를 같은 무게로 다루면 안 됩니다.
- 근거와 모르는 것. 좋은 결과는 결론만이 아니라 다시 확인할 수 있는 위치(파일 오프셋, 주소, 문자열, 호출 관계)와, 아직 확인하지 못한 부분을 함께 담습니다.
- 설명이나 재구현. 에이전트가 근거를 바탕으로 동작을 설명하거나 비슷한 코드를 다시 써 봅니다. 이것은 가설입니다.
- 사람의 확인. 재현해 보고, 원래 동작과 비교하고, 받아들일지 판단합니다. 여기서 생긴 의문이 다음 질문이 됩니다.
이 흐름에서 REA가 맡는 부분은 3과 4입니다. 나머지는 에이전트와 사람의 몫이고, 특히 5와 7을 건너뛰면 그럴듯한 이야기만 남습니다.
무엇을 분석할 수 있나
REA가 다룰 수 있다고 밝히는 대상은 README의 What you can analyze 절에 큰 표로 정리되어 있습니다. 표는 자주 바뀌므로 여기에 옮기지 않고, 읽을 때 볼 점만 적어 둡니다.
- 대상 유형마다 필요한 것이 다릅니다. 리버스 엔지니어링에서 흔히 만나는 대상은 크게 네이티브 실행 파일(Windows의 PE, Linux의 ELF, macOS의 Mach-O), .NET이나 JVM처럼 바이트코드로 배포되는 관리형 코드, 번들된 JavaScript와 Electron 앱, Android 패키지 같은 모바일 앱으로 나눌 수 있습니다. 여러분의 대상이 표의 어느 줄에 해당하는지 먼저 찾으세요.
- REA가 직접 하는 검사와 외부 도구에 기대는 작업을 구분하세요. 일부 기능은 따로 설치한 외부 도구(provider)가 있어야 동작합니다. 사용자가 지정한 objdump, GDB, Rizin, Cutter 같은 도구와의 연동은 리버스 엔지니어링 도구 문서에 따로 설명되어 있습니다. 그 도구들은 REA의 일부가 아니라 각자의 라이선스와 이용 조건을 가진 별도 소프트웨어입니다.
- 정적 작업인지 런타임 작업인지 확인하세요. 같은 대상이라도 파일만 읽는 기능과 실행하거나 붙는 기능은 위험이 다릅니다.
설치 방법은 설치 문서와 공식 가이드를 따르는 것이 가장 안전합니다. 이 글에 설치 명령을 따로 적지 않는 이유는, 버전마다 바뀔 수 있고 비슷한 이름의 복제 저장소나 패키지가 있을 수 있기 때문입니다. 공식 저장소, 공식 사이트, 거기서 연결한 패키지만 쓰고, 설정 파일을 바꾸는 단계가 있다면 무엇이 바뀌는지 먼저 확인하고, 문서에 미리 보기(dry run)나 준비 상태 점검이 있다면 그것부터 실행하세요.
왜 지금 주목받나
2026년 10월 14일 GitHub API로 확인한 저장소 정보는 이렇습니다.
| 항목 | 값 |
|---|---|
| 저장소 생성일 | 2026년 4월 14일 |
| 스타 | 217,251 |
| 포크 | 53,662 |
| 확인한 최신 릴리스 | rea-agents-6.4.0, 2026년 10월 11일 게시 |
반년 만에 이 정도 숫자가 쌓였다는 것은 많은 사람이 관심을 보였다는 뜻입니다. 그 이상은 아닙니다. 스타와 포크는 코드가 정확하다거나 안전하다거나 성숙했다는 증거가 아니고, 여러분의 대상에서 잘 동작한다는 보장도 아닙니다. 숫자는 확인한 날짜의 스냅숏이며 지금은 다를 수 있습니다.
관심이 몰린 배경은 짐작할 수 있습니다. 코딩 에이전트가 MCP로 외부 도구를 쓰는 일이 흔해지면서, 디스어셈블러와 디버거처럼 배우기 어려운 도구를 에이전트에게 맡기려는 수요가 생겼습니다. 다만 이것은 이 글의 해석이고, 프로젝트가 밝힌 동기는 아닙니다.
시작 전에 알아 두면 좋은 것
전부 익힌 뒤에 시작할 필요는 없습니다. 에이전트가 무엇을 하는지 따라갈 수 있을 만큼만 알아도 첫 조사는 할 수 있고, 모르는 부분은 조사하면서 채우면 됩니다. 아래는 대략 이 순서로 넓혀 가면 좋다는 제안입니다.
- 파일은 바이트입니다. 16진수 덤프를 읽고, 매직 넘버와 헤더로 형식을 알아보는 데서 시작합니다. 실행 파일 형식은 Microsoft의 PE 형식 문서와 Linux elf(5) 매뉴얼이 원전입니다. 섹션, 심볼, 임포트가 무엇인지만 알아도 도구 출력이 훨씬 잘 읽힙니다.
- 어셈블리와 호출 규약. 함수 인자가 어느 레지스터나 스택으로 넘어가는지 알아야 디스어셈블리를 따라갈 수 있습니다. 같은 x86-64라도 Windows(x64 호출 규약)와 Linux·macOS(System V ABI)가 다릅니다. 처음에는 직접 짠 작은 C 함수를 컴파일해 결과를 보는 것이 가장 빠릅니다.
- 정적 분석과 동적 분석. 실행하지 않고 읽는 것과 실행하며 관찰하는 것의 차이, 그리고 각각 무엇을 놓치는지 압니다. Ghidra 같은 디컴파일러를 직접 열어 보면, 에이전트가 같은 종류의 출력을 어떻게 해석하는지 비교할 수 있습니다.
- 프로세스, 메모리, 디버깅. 프로세스의 주소 공간, 중단점, 단계 실행을 이해합니다. GDB 문서나 여러분 플랫폼의 디버거 문서가 출발점입니다.
- 대상에 맞는 플랫폼 지식. 웹과 Electron 앱이라면 JavaScript 번들과 ASAR 아카이브를, Android라면 DEX 형식을, .NET이라면 ECMA-335의 메타데이터와 IL을 봅니다. 셋을 다 할 필요는 없고, 지금 볼 대상 하나만 고르면 됩니다.
- MCP와 도구의 경계. MCP 공식 문서에서 서버, 도구, 클라이언트가 무엇이고 도구 결과가 어디로 가는지 읽어 둡니다. 어떤 도구 호출이 무엇을 바꾸는지 알아야 에이전트에게 허락할 범위를 정할 수 있습니다.
- 근거, 불확실성, 재현성. 결론마다 근거가 되는 위치를 남기고, 확인하지 못한 것은 확인하지 못했다고 적고, 다른 사람이 같은 입력으로 같은 결과를 얻을 수 있게 기록하는 습관입니다. 도구보다 오래 남는 기술입니다.
REA 쪽 자료는 공식 가이드와 저장소의 docs/ 폴더가 기준입니다.
첫 연습: 내가 만든 프로그램으로
첫 대상은 여러분이 직접 짠 프로그램이 가장 좋습니다. 정답, 곧 소스 코드를 여러분이 갖고 있기 때문입니다. 교육용으로 공개된 예제나 참가 규칙상 분석이 허락된 CTF 문제도 괜찮습니다. “공개적으로 내려받을 수 있다”는 것은 분석해도 된다는 허락이 아닙니다.
개념적인 순서는 이렇습니다.
- 설정 파일 하나를 읽고, 값에 따라 다른 메시지를 출력하는 작은 프로그램을 씁니다.
- 디버그 정보를 넣은 빌드와 최적화하고 심볼을 뺀 빌드를 각각 만듭니다.
- 소스는 보여 주지 않은 채, 에이전트에게 “이 프로그램은 어떤 파일을 읽고, 어떤 조건에서 어떤 메시지를 출력하나?“라고 묻습니다. 처음에는 정적 분석만 허용합니다.
- 답에 붙은 근거(주소, 문자열, 호출 관계)와 “확인하지 못했다”고 한 부분을 소스와 하나씩 맞춰 봅니다.
- 두 빌드의 답을 비교합니다. 심볼이 없을 때 무엇이 흐려지는지, 에이전트가 그 빈자리를 근거 없이 메웠는지 봅니다.
이 연습의 목표는 정답을 맞히는 것이 아니라, 에이전트의 설명이 언제 근거를 따르고 언제 추측으로 넘어가는지 감을 잡는 것입니다.
한계와 경계
- 데이터 흐름. REA가 대상을 올리지 않는다고 해도, 에이전트가 받은 도구 결과(문자열, 디컴파일된 코드, 캡처된 내용)는 모델 제공자에게 갑니다. 개인정보나 비밀이 담길 수 있는 대상이라면 이 점을 먼저 따져 보세요.
- 상태 변경. 실행, 디버거 연결, 트래픽 캡처, 기기 조작은 파일을 만들고 지우거나, 네트워크 요청을 보내거나, 기기 설정을 바꿀 수 있습니다. 런타임 작업은 버려도 되는 환경에서 하세요.
- 격리 없음. 앞에서 말했듯 REA는 샌드박스가 아니고, 같은 사용자로 돌아가는 악성 프로세스는 보안 정책의 범위 밖입니다.
- 틀릴 수 있는 결론. 디컴파일러는 원래 코드를 되살리지 않고 그럴듯한 형태로 다시 씁니다. 모델은 그 위에서 또 한 번 추측합니다. 중요한 결론은 직접 확인하세요.
- 권리와 책임. REA가 직접 작성한 코드는 MIT 라이선스입니다. 함께 쓰는 외부 도구는 제3자 고지와 각 도구의 조건을 따르고, 분석 대상에 대한 권리는 또 별개입니다. 프로젝트의 책임 있는 사용 고지도 분석 권한, 라이선스, 개인정보, 대상의 권리를 지키는 책임이 사용자에게 있다고 밝힙니다. 대상의 이용 약관이 리버스 엔지니어링을 어떻게 다루는지, 여러분이 있는 곳의 법이 무엇을 허용하는지는 경우마다 다르고 이 글이 판단해 줄 수 없습니다. 확실하지 않다면 분석하지 않거나 전문가에게 물어보세요.
최근 소식과 앞으로 볼 것
2026년 10월 14일에 확인한 최신 릴리스는 10월 11일에 게시된 rea-agents-6.4.0입니다. 릴리스 노트가 밝힌 주요 변경은 이렇습니다. 이 글에서 직접 시험해 본 것은 아닙니다.
- Android 기기 검사와 리소스 디코딩
- 사용자가 직접 띄운 로컬 JEB MCP 서버를 통한 탐색과 디컴파일
- 큰 분석에서 근거(Evidence) 요약과 선택한 뷰를 보존
- Ghidra 가져오기에서 언어, 컴파일러, 시드 설정
- JavaScript 소스 분석의 자원 사용 상한. 한도에 닿으면 그때까지 확인한 사실과 확인하지 못한 부분을 명시해 돌려줍니다.
변경 내용은 버전마다 다르므로, 업데이트할 때는 릴리스 목록에서 바뀐 점, 특히 도구 계약이나 설정이 바뀌었는지를 먼저 읽는 편이 좋습니다.
앞으로의 방향은 프로젝트의 로드맵에 있습니다. 로드맵이 밝힌 우선순위는 네이티브 코드의 아키텍처, 타입, 간접 호출 검증을 넓히는 것, 정적 분석 결과와 런타임 관찰을 여러 계층에 걸쳐 잇는 것, 난독화된 관리형 코드의 비교와 네이티브 코드와의 연결을 개선하는 것, 프로세스, 프로토콜, 파일 시스템, 재연결, 빌드 비교의 범위를 넓히는 것입니다. 로드맵은 계획이지 약속이 아니므로, 실제로 들어왔는지는 릴리스 노트로 확인하세요.
이어지는 시리즈
좁은 질문 하나씩을 더 깊이 다룬 글 네 편이 이어집니다. 이 글처럼 문서와 공개된 후기를 바탕으로 했고, Motitory가 REA를 실행해 쓴 글은 아닙니다.
- 최근 글들은 실제로 무엇을 시험했나: 독립 실행, 작성자 주장 데모, 뉴스와 의견을 나눠 읽기
- 할 수 있는 것과 한계: 가능·조건부·미지원의 경계와 Evidence 읽는 법
- 장점과 대가, 그리고 앞으로의 시나리오: 짝을 이루는 장단점과 다섯 가지 조건부 시나리오
- 안전하게 시작하기: 공식 픽스처로 하는 첫 연습, 팀 점검표, 30/60/90일 계획
참고한 문서
- morluto/rea 저장소와 README(분석 대상 표: What you can analyze), 공식 사이트와 가이드
- 저장소 문서: 설치, CLI, MCP 계약, 아키텍처, 리버스 엔지니어링 도구, 로드맵
- 보안 정책, 책임 있는 사용 고지, 라이선스, 제3자 고지
- 릴리스 목록, GitHub 저장소 API
- 배경 자료: PE 형식, elf(5), x64 호출 규약, Ghidra, GDB 문서, Electron ASAR, DEX 형식, ECMA-335, MCP
링크와 내용은 2026년 10월 14일에 확인했습니다.