UUID v4와 v7, 무엇을 써야 할까: 128비트의 구조와 충돌 확률
UUID의 8-4-4-4-12 형식에서 버전과 변형 비트의 위치, v4의 실제 충돌 확률, 시각이 앞에 오는 v7이 데이터베이스 인덱스에 유리한 이유를 RFC 9562를 기준으로 정리했습니다.
쇼핑몰 주문 상세 페이지의 주소가 /orders/1043이라면, 누군가는 반드시 주소창의 숫자를 1044로 바꿔 봅니다. 권한 검사가 제대로 되어 있으면 아무 일도 일어나지 않지만, 적어도 “이 가게는 지금까지 주문을 천 건 조금 넘게 받았다”는 사실은 새어 나갑니다. 두 서비스의 데이터베이스를 합칠 때는 더 곤란합니다. 양쪽에 모두 1043번 주문이 있으니까요.
그래서 ID를 d25c11b5-3995-48e8-8c0f-8be9a1550bcc 같은 UUID로 바꾸기로 했다고 해 봅시다. 그다음 질문은 “어떤 UUID로?“입니다. 요즘은 대개 v4와 v7 가운데 하나를 고르게 되는데, 둘의 차이는 32자리 중 앞의 12자리에 있습니다.
32자리 안에 고정된 두 글자
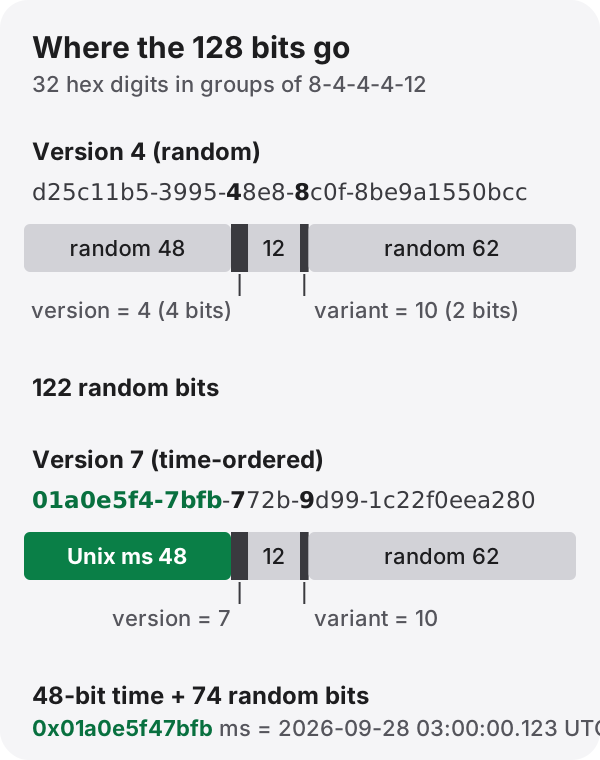
UUID는 128비트 값을 16진수 32자리로 적고 8-4-4-4-12 자리로 하이픈을 넣은 것입니다. 이 가운데 두 곳은 무작위가 아닙니다.
- 세 번째 묶음의 첫 글자가 버전입니다.
48e8의4가 “이것은 v4”라는 표시입니다. - 네 번째 묶음의 첫 글자에는 변형(variant) 비트가 들어갑니다. 지금 쓰이는 UUID는 이 자리의 앞 두 비트가
10이라서, 글자로는 항상8,9,a,b중 하나입니다.
아무 UUID나 보고 이 두 글자를 확인하면 버전을 바로 알 수 있습니다. 로그에 찍힌 ID가 …-7…로 시작하는 세 번째 묶음을 갖고 있다면 v7입니다.
v4: 122비트짜리 주사위
v4는 버전과 변형에 쓰는 6비트를 뺀 122비트를 전부 난수로 채웁니다. 가능한 값은 2¹²²개, 약 5.3×10³⁶개입니다.
“그래도 언젠가 겹치지 않을까”라는 질문에는 생일 문제로 답할 수 있습니다. 서로 다른 값 N개 중에서 k개를 무작위로 뽑을 때 하나라도 겹칠 확률은 대략 k²/(2N)입니다. 직접 계산해 보면 이렇습니다.
| 만든 UUID 수 | 한 번이라도 겹칠 확률 |
|---|---|
| 10억 개 (10⁹) | 약 9.4×10⁻²⁰ |
| 1조 개 (10¹²) | 약 9.4×10⁻¹⁴ |
| 약 2.7×10¹⁸개 | 약 50% |
마지막 줄은 1초에 10억 개씩 86년 동안 만들어야 도달하는 수입니다. 현실에서 충돌을 걱정해야 하는 경우는 수학이 아니라 난수가 나쁠 때입니다. Math.random()처럼 암호학적이지 않은 난수로 UUID를 흉내 내거나, 가상 머신을 복제해서 난수 생성기 상태까지 똑같아진 경우입니다. 브라우저와 Node.js의 crypto.randomUUID()는 암호학적 난수로 v4를 만들어 주므로 이런 걱정을 덜 수 있습니다.
무작위라서 생기는 불편: 인덱스
v4의 약점은 충돌이 아니라 순서가 없다는 것입니다. PostgreSQL이나 MySQL(InnoDB)의 기본 인덱스는 B-트리이고, 키를 정렬된 상태로 페이지에 나눠 담습니다. 자동 증가 ID는 항상 맨 오른쪽 끝에 새 값이 붙으므로 마지막 페이지 하나만 뜨겁게 쓰입니다.
v4는 새 값이 인덱스의 아무 곳에나 떨어집니다. 행이 수천만 개가 되면 삽입할 때마다 메모리에 없던 페이지를 디스크에서 읽어 와야 할 가능성이 커지고, 꽉 찬 페이지가 이곳저곳에서 쪼개집니다. 쓰기는 느려지고 인덱스는 듬성듬성해집니다. 특히 MySQL InnoDB는 테이블 자체가 기본 키 순서로 저장되기 때문에 이 영향을 크게 받습니다.
v7: 앞 48비트에 시각을
2024년 5월에 나온 RFC 9562는 기존 RFC 4122를 대체하면서 새 버전 v6, v7, v8을 정했습니다. 이 중 v7이 위 문제에 대한 답입니다.
v7의 맨 앞 48비트는 밀리초 단위 유닉스 시각입니다. 그 뒤로 버전 4비트, 무작위 12비트, 변형 2비트, 무작위 62비트가 이어집니다. 무작위 부분은 74비트로 v4보다 적지만, 같은 밀리초 안에서만 겹치지 않으면 되므로 충분합니다.
01a0e5f4-7bfb-772b-9d99-1c22f0eea280의 앞 12자리 01a0e5f47bfb를 10진수로 바꾸면 1790564400123이고, 이는 2026년 9월 28일 03:00:00.123 UTC, 한국 시각으로 낮 12시 0.123초입니다. 나중에 만든 UUID일수록 값이 크므로, 문자열로 정렬해도 만든 순서가 됩니다. 인덱스에서는 자동 증가 ID처럼 오른쪽 끝에 쌓입니다.
48비트 밀리초는 서기 10889년까지 셀 수 있으니 수명 걱정은 없습니다. 대신 생성 시각이 ID에 그대로 드러난다는 점은 기억해야 합니다. 회원 ID만 보고 가입 시점을 알 수 있어도 괜찮은지는 서비스마다 판단할 일입니다.
v1과 v6은 어디로 갔나
v1은 1582년 10월 15일부터 센 100나노초 단위 시각과 장비의 MAC 주소로 만듭니다. MAC 주소가 들어가서 어느 기계가 만든 ID인지 드러나고, 시각 비트가 뒤섞인 순서로 배치되어 있어 정렬해도 시간순이 되지 않습니다. v6은 v1의 시각 비트를 순서대로 다시 배치한 것으로, 이미 v1을 쓰는 시스템을 위한 버전입니다. 새로 시작한다면 RFC 9562도 v1·v6보다 v7을 권합니다.
무엇을 고를까
| 자동 증가 정수 | UUID v4 | UUID v7 | |
|---|---|---|---|
| 크기 | 4–8바이트 | 16바이트 | 16바이트 |
| 다음 값 추측 | 쉬움 | 불가능 | 시각 부분은 추측 가능, 나머지는 불가능 |
| 여러 곳에서 동시에 발급 | 중앙 발급 필요 | 가능 | 가능 |
| B-트리 삽입 | 끝에 추가 | 아무 곳에 | 거의 끝에 추가 |
| 생성 시각 노출 | 순서만 | 없음 | 밀리초까지 |
데이터베이스 기본 키로 UUID를 쓴다면 v7이 무난합니다. PostgreSQL 18은 uuidv7() 함수를, Python 3.14는 uuid.uuid7()을 기본으로 제공합니다. 시각이 드러나면 곤란한 값, 예를 들어 공유 링크의 토큰이라면 v4가 낫습니다. 다만 추측할 수 없는 링크 토큰이 목적이라면 UUID보다 더 긴 난수 토큰을 쓰는 것도 방법입니다. 어떤 경우든, UUID를 썼다고 권한 검사를 생략해도 되는 것은 아닙니다.
UUID 생성기는 브라우저의 암호학적 난수로 v4와 v7을 여러 개 한꺼번에 만들어 줍니다. v7을 몇 개 만들어 보면 앞자리가 거의 같고 뒤로 갈수록 달라지는 모습을 볼 수 있습니다.
참고
- RFC 9562, Universally Unique IDentifiers (UUIDs) (2024)
- RFC 4122, A Universally Unique IDentifier (UUID) URN Namespace (RFC 9562로 대체됨)
- W3C Web Cryptography API,
Crypto.randomUUID() - PostgreSQL 18 문서, UUID Functions / Python 3.14 문서,
uuid모듈